Jevとは?AIエージェント高速化で変わるAI駆動開発とハーネス設計 | 人間のレビューが追いつかない時代に備えて
AI駆動開発を進めていると、最近かなり強く感じる問題があります。
AIがコードを書く速度に、人間の確認速度が追いつかない。
Claude CodeやCodexなどを1つだけ動かしている段階では、それほど大きな問題にならないかもしれません。
しかし、
- フロントエンド担当AI
- バックエンド担当AI
- テスト担当AI
- コードレビュー担当AI
- 調査担当AI
といった形で複数エージェントを並列に動かし始めると、状況が変わります。
数十分後には、
「PRが5本できています」
「テストコードを追加しました」
「リファクタリングもしました」
「ここは仕様判断が必要です」
という状態になります。
AIは待ってくれません。
結果として、
AIを動かすことより、AIがやったことを人間が確認することのほうが時間がかかる
という逆転現象が起こります。
そこへ2026年9月に登場したのが、TypeSafe AIの Jev です。
JevはGPTやClaudeのように文章を生成することを中心にしたモデルではありません。
TypeSafeはJevを、
unstructured state in, typed probabilistic decisions out
つまり、
「状態を渡すと、型付きの判断と確率を返すモデル」
として位置付けています。
通常のLLMがトークンを順番に生成するのに対し、Jevは複数の判断を並列に出力できます。TypeSafeによれば応答時間はおよそ70〜500msで、分類・ルーティング・スコアリング・検証などを主な用途としています。
ここで一つ疑問が出てきます。
AIの判断がさらに速くなったら、誰がそれを確認するのか?
これは、Jevそのものよりも重要な問題かもしれません。
Jevによって「AIの判断回数」が一気に増える
従来のAIエージェントでは、判断そのものに時間がかかっていました。
例えばAIコーディングエージェントなら、
コードを書く
↓
LLMが考える
↓
テスト
↓
LLMが結果を見る
↓
修正
↓
LLMが再判断
という形です。
この「LLMが考える」という工程が数秒〜数十秒かかるため、自然に速度制限がかかっていました。
ところがJevのようなモデルを途中に入れると、
Claude / Codex
コード生成
      ↓
Jev
危険な変更?
テスト不足?
互換性問題?
セキュリティ問題?
      ↓
問題あり
      ↓
Claude / Codex
修正
      ↓
Jev
再評価
というループをかなり高速に回せます。
しかもJevは、一つずつ質問する必要がありません。
例えば一回の変更に対して、
correctness
security
test_coverage
backward_compatibility
maintainability
architecture_violation
secret_exposure
database_risk
といった複数項目を一度に評価することができます。
TypeSafe自身も、信頼性の高いワークフローでは「独立した細かい質問を分解して多数評価し、その確率を使ってコード側で処理する」ことが重要だと説明しています。
つまりJevによって起こるのは、
AIが賢くなる
だけではなく、
1秒間に実行できるAI判断の数が増える
という変化です。
実際にJevをコードレビューへ使う実装が出始めている
すでに海外では、JevをAI駆動開発へ組み込む実験が始まっています。
Xで流れていた海外事例まとめでも、PRを14項目で評価する例が紹介されています。
そこでは、
- 秘密情報の混入
- データベースに対する危険な処理
- テスト削除
- その他コード変更のリスク
などをJevで判定しています。
さらに面白いのが、すでにGitHub上に登場している jev-review のような実験です。
ある実装では、
Git diff
↓
Jev
↓
correctness
security
reliability
compatibility
test coverage
↓
リスクのある箇所を抽出
↓
必要な箇所だけ詳しくレビュー
という段階的なコードレビューをしています。
重要なのは、Jevにコードレビュー全文を書かせていないことです。
Jevは、
「この変更は危ないか」
「どのコードを詳しく見るべきか」
「重大度はいくつか」
という判断を担当します。
最終的な制御はプログラム側に残しています。
Claude Code・Codex用の「品質センサー」として使う実装も登場
さらに興味深い例があります。
別のjev-reviewでは、JevをMCPサーバーとして動かし、
- Claude Code
- Codex
- Cursor
- OpenCode
などから呼び出せるようにしています。
流れとしては、
Claude Code
   ↓
コードを書く
   ↓
テスト
   ↓
Jev Review
   ↓
品質スコア
   ↓
Claude Code
原因を考える
   ↓
修正
   ↓
Jev Review
となっています。
Jevは、
- correctness
- complexity
- changeability
- modularity
- tests
- security
- compatibility
などを評価します。
そして非常に重要なのが、
Jevが修正方法を考えるのではない
という点です。
Jevはあくまでセンサーです。
原因を分析し、修正するのはClaude CodeやCodexです。
これはAI駆動開発においてかなり良い役割分担だと思います。
Jevは「AIの上司」というより「AI用のセンサー」に近い
例えば人間の開発組織なら、
エンジニア
↓
コードを書く
↓
テスト
↓
CI
↓
コードレビュー
↓
QA
があります。
AI駆動開発も同じで、
Coding Agent
↓
Deterministic Tests
↓
Static Analysis
↓
Jev
↓
Verifier Agent
↓
Human
という階層を作る必要があります。
ここで重要なのは、
全部AIに判断させないことです。
むしろ、
確実に機械で判断できるものほどAIを使わない
くらいでよいと思います。
例えば、
TypeScript compile
ESLint
unit test
E2E test
schema validation
dependency rules
は普通のプログラムで判定できます。
Jevを使うべきなのは、
この修正は仕様意図とズレていないか?
この変更は将来壊れやすそうか?
この差分はレビュー優先度が高いか?
このテストは本当に変更内容をカバーしているか?
といった、
普通のif文では書きづらい判断
です。
ただし「JevがOKと言ったから安全」は危険
ここはかなり重要です。
Jevは高速ですが、
高速=正確
ではありません。
公開された独立ベンチマークの一例では、2,000件のフィッシングメール分類について、
| モデル | Accuracy |
|---|---|
| Jev | 62.6% |
| Claude Haiku 4.5 | 81.3% |
という結果になっています。
Jevは速度とコストでは優位でしたが、単純な最終判定ではClaudeのほうが高精度でした。
ところが面白いことに、Jevへ、
これはフィッシングか?
と一問だけ聞くのではなく、
無料ホスティングを使っている?
送信元とリンク先ドメインが違う?
短縮URL?
不審なドキュメント共有?
その他の危険シグナル?
と判断を分解し、その結果を通常のロジックで組み合わせると精度が大きく改善しました。
これは非常に重要な示唆です。
Jev時代には「AIに結論を聞く」のをやめる
例えば、
このPRは安全?
とJevに聞いて、
YES 92%
だからマージする。
これは危険です。
そうではなく、
SQL migrationあり?
      92%

auth変更あり?
      4%

public API変更あり?
      76%

既存テスト不足?
      81%

secret混入?
      1%

rollback困難?
      87%
と分解します。
そして判断はコード側で行います。
DB migration > 70%
      → human review

public API change > 60%
      → compatibility test

test gap > 70%
      → test agent

secret > 20%
      → merge禁止
つまり、
AIに意思決定を丸投げするのではなく、AIを特徴量生成器として使う
という設計です。
これはJevのかなり重要な使い方になると思います。
では、人間のレビューはどうするのか?
ここが本題です。
AIが10倍速くなったとして、人間が全部確認していたら意味がありません。
例えば10エージェントを同時に動かして、
Agent A → PR
Agent B → PR
Agent C → PR
Agent D → PR
Agent E → PR
となった場合、人間が全部のdiffを読む設計はすぐ限界になります。
そこで必要になるのが、
Risk Based Human Review
です。
つまり、
人間は全件レビューしない。
例えば、
                    ┌ Low Risk
                    │ → 自動テスト
                    │ → 自動マージ
                    │
Coding Agent → Jev ├ Medium Risk
                    │ → Verifier Agent
                    │
                    └ High Risk
                      → Human Review
とします。
人間は、
判断が難しいところだけ確認する。
confidenceだけを信用してはいけない
ただし、
confidence > 95%
→ 自動マージ
だけでも危険です。
Jevは確率・confidenceを返すことを大きな特徴としており、TypeSafeはこれをRLCD(Reinforcement Learning for Calibrated Decisions)で学習していると説明しています。
とはいえ、
confidenceは証明ではありません。
共有いただいた記事でも、
決められた形式で答えることと、判断を絶対に間違えないことは別
と整理されています。
したがって、
confidence
+
変更内容
+
テスト結果
+
影響範囲
+
ルール
を組み合わせる必要があります。
AI駆動開発では「3種類の検証」を分離するとよい
個人的には今後、次の3層が重要になると考えています。
Layer 1:Deterministic Verification
普通のプログラムで確認します。
Build
TypeCheck
Lint
Unit Test
Integration Test
E2E
Dependency Check
Security Scan
ここはAI不要です。
正しい・間違いを機械的に判定できます。
Layer 2:Probabilistic Verification
Jevの領域です。
仕様との整合性
変更リスク
テスト不足
アーキテクチャ違反の可能性
互換性リスク
セキュリティ懸念
レビュー優先度
などを判定します。
Layer 3:Deep Verification
GPT / Claudeなどを使います。
例えばJevが、
architecture risk = 0.84
を返したら、
Claudeに、
なぜarchitecture riskが高いのか調査せよ
と渡します。
つまり、
Jev
↓
異常検知
↓
Claude / GPT
↓
原因調査
です。
そして最後にHuman Review
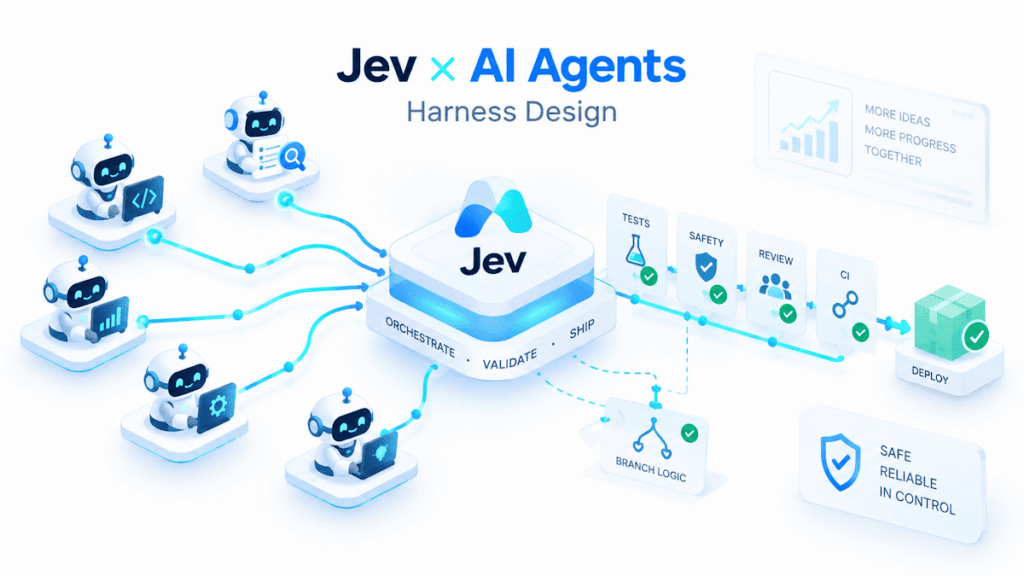
全体としてはこうなります。
┌──────────────────────────┐
│ Coding Agent             │
│ Claude Code / Codex      │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│ Deterministic Harness    │
│ build / test / lint      │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│ Jev                      │
│ Risk / Quality / Policy  │
└────────────┬─────────────┘
             ↓
       ┌─────────────┐
       │ risk low?   │
       └──────┬──────┘
          YES │      NO
              │       ↓
              │    Claude
              │    Deep Review
              │       ↓
              │    High Risk?
              │       ↓
              │     Human
              ↓
          Auto Merge
このくらいまで機械化しないと、並列エージェント時代には人間が持たないと思います。
Anthropicの16並列Claude実験でも「ハーネス」が核心だった
これはJevに限った話ではありません。
Anthropicは2026年2月、16個のClaudeを並列稼働させ、RustでCコンパイラを作る実験を公開しています。
約2,000回のClaude Codeセッションを動かし、約10万行のコンパイラを作成しました。Linux 6.9をx86、ARM、RISC-V向けにビルドできるところまで到達しています。
しかしAnthropicが記事の中で強調しているのは、
「Claudeが賢かった」
だけではありません。
むしろ、
Most of my effort went into designing the environment around Claude—the tests, the environment, the feedback.
つまり、
大量の時間を使ったのはAIではなく、その周囲のテスト・環境・フィードバック設計だった
としています。
特に重要なのが、
テストハーネスが間違っていたら、Claudeは間違った目標を一生懸命解いてしまう
という指摘です。
そのため、
- 高品質なテスト
- CI
- regression detection
- deterministic test sampling
- task locking
- known-good implementationとの比較
などを作っています。
OpenAIも「人間がコードを書く」から「ハーネスを作る」へ移行している
OpenAIも2026年2月に興味深い事例を公開しています。
ある内部プロジェクトで、
手書きコード0行
という制約を設定し、Codexだけでプロダクトを開発しました。
約5か月で100万行規模、約1,500 PRを処理しています。
ここでも考え方は非常に似ています。
Humans steer. Agents execute.
つまり、
人間は方向を決め、AIが実行する。
そして人間の仕事は、
- 環境設計
- 仕様定義
- acceptance criteria
- feedback loop
- architecture constraints
へ移っています。
「レビューコメント」を増やすのではなく「ルール」に変える
OpenAIの事例で特に面白いのがここです。
AIが同じ間違いを繰り返した場合、
人間が毎回、
ここ直してください。
とレビューするのではありません。
その指摘を、
lint rule
architecture rule
structural test
documentation
へ変換します。
例えば、
Types
↓
Config
↓
Repository
↓
Service
↓
Runtime
↓
UI
という依存方向を決め、
逆向きの依存を自動的に禁止する、といったルールを機械化しています。
これはAI駆動開発で非常に重要な考え方です。
つまり、
人間のレビューを再利用可能なハーネスへ変換する。
人間レビューを「教師データ」にする
例えば人間がPRを見て、
Repository層からUIを直接呼んでいるのでダメ。
と一度指摘したとします。
その指摘をそのまま終わらせません。
Human Review
↓
Rule化
↓
Lint / Test
↓
次回から自動チェック
とします。
次から人間は同じレビューをしません。
さらに曖昧な判断なら、
Human Review
↓
Jev question追加
でもよいでしょう。
例えば、
Does this change introduce
business logic into UI layer?
というチェックを追加する。
こうしていくと、
人間レビューそのものがハーネスを育てる材料
になります。
Jevが入ると、このサイクルをさらに高速化できる
ここでJevが効いてきます。
従来、
Agent
↓
Human Review
↓
Agent
だったものが、
Agent
↓
Tests
↓
Jev
↓
Verifier Agent
↓
必要なものだけHuman
になります。
そしてHumanが新しい問題を発見したら、
新しいテスト
新しいlint
新しいJev question
新しいpolicy
としてハーネスに戻します。
結果、
Human Knowledge
      ↓
Harness
      ↓
Agents
      ↓
大量実行
      ↓
新しいFailure
      ↓
Human
      ↓
Harness改善
というループになります。
これは「AIを管理する」のではなく「AIが失敗できる範囲を設計する」
AIエージェント管理というと、
AIが正しいか逐一監視するイメージがあります。
しかし並列化が進めば、それは現実的ではありません。
むしろ、
間違っても壊れない環境を作る
ほうが重要です。
例えば、
Agentに本番DB権限を与えない
Agentはfeature branchのみ変更可能
migrationは自動適用禁止
認証変更は必ずHuman Review
決済コード変更はHigh Risk固定
とする。
つまり、
能力を制御するより権限を制御する。
Jevを使うなら「拒否・保留」という選択肢を必ず作る
AI分類でよくある失敗が、
A
B
C
のどれかを必ず選ばせることです。
分からなくてもどれかを選びます。
そこで、
A
B
C
UNKNOWN
HUMAN_REVIEW
を用意する。
共有いただいた記事でも、分類できない場合に人へ戻す選択肢を用意する重要性が指摘されています。
実運用なら、
confidence < 70%
→ UNKNOWN

high impact
→ HUMAN_REVIEW

conflicting signals
→ DEEP_REVIEW
くらいでよいでしょう。
並列エージェント時代のおすすめ構成
AI駆動開発であれば、個人的にはこの構成がかなり現実的だと思います。
                     ┌ Agent A
                     ├ Agent B
Requirement
     ↓               ├ Agent C
Task Planner ────────┼ Agent D
                     └ Agent E
                          ↓
                     Git Branch
                          ↓
             ┌────────────────────┐
             │ Deterministic CI   │
             │ Test / Lint / Build│
             └─────────┬──────────┘
                       ↓
                  Jev Review
                       ↓
           ┌───────────┼───────────┐
           ↓           ↓           ↓
        LOW          MEDIUM       HIGH
           ↓           ↓           ↓
       Auto Merge   Claude      Human
                     Review
ポイントは、
人間を正常系から外すことです。
人間が見るのは、
- 高リスク
- 判断が割れたもの
- 新しいfailure pattern
- 仕様そのものが曖昧なもの
だけです。
ただし「AI reviewerを増やせば安全」でもない
ここも注意したいところです。
例えば、
Claudeが書く
↓
GPTがレビュー
↓
Jevがレビュー
↓
Claudeが再レビュー
とすれば安全そうに見えます。
しかし同じ情報を見て同じようなモデルが判断すると、
同じ間違いを全員が見逃す
可能性があります。
だから重要なのはモデル数より、
検証方法の異質性
です。
例えば、
生成
Claude

コンパイル
TypeScript

ロジック
Unit test

ブラウザ
Playwright

セキュリティ
Semgrep

判断
Jev

深掘り
GPT / Claude

最終仕様
Human
とする。
違う仕組みで検証することが重要です。
「速度競争」より「検証コスト競争」になる
ここまで考えると、Jevで興味深いのは単純な高速化ではありません。
今後、
コード生成速度
はどんどん上がっていきます。
するとボトルネックは、
生成
↓
検証
↓
生成
↓
検証
の検証側に移ります。
つまりAI駆動開発で競争力になるのは、
「一番コードを書くAIを使っている会社」
というより、
大量のAI生成物を安く・速く・安全に検証できる会社
になる可能性があります。
JevはAI駆動開発に使えるのか?
結論としては、
かなり相性が良いと思います。
ただし、
Jevにコードを書かせる
のではありません。
Claude / Codex
→ コードを書く

Jev
→ 判断する
という分業です。
例えば、
- タスク振り分け
- 使用モデル選択
- 必要ファイル選択
- コンテキスト圧縮
- PRリスク判定
- テスト不足判定
- セキュリティチェック
- Human Review判定
- Reviewer Agent選択
などです。
共有いただいた事例でも、Claude Codeに渡すログをJevで評価し、不要な情報を除外する「instant compaction」が試されています。
これは長時間動作するCoding Agentにかなり相性が良い考え方です。
重要なのは「AIを速くする」のではなく「人間をボトルネックから外す」こと
Jevの登場を見ていると、
「300msでAIが判断できる」
という速度に目が行きます。
しかし、それ以上に重要なのは、
人間がAIのすべてを確認する開発方法が限界に近づいている
ことだと思います。
AIが1人分の仕事をしていた時代なら、
AI
↓
Human
でよかった。
しかし、
Agent × 10
Agent × 50
Agent × 100
となれば、人間が全部を見ることはできません。
そこで必要になるのが、
Agent
↓
Harness
↓
Agent
↓
Harness
↓
Human only when needed
という構造です。
まとめ:これからのAI駆動開発は「コードを書く力」より「制御する力」
Jevは非常に新しい技術で、公開からまだ日が浅く、現在出ている事例の多くもプロトタイプです。
したがって、
Jevを入れればAI開発が安全になる
と考えるのは早いでしょう。
一方で、方向性はかなり興味深いものがあります。
TypeSafeが目指しているのは、
LLM
↓
文章
ではなく、
AI
↓
判断
↓
Software
という世界です。
そしてAIが高速化すると、
人間の仕事も、
コードを書く
から、
テストを書く
へ。
さらに、
テストを書く
から、
AIが正しく仕事できる環境・制約・評価基準を設計する
へ変わっていくのかもしれません。
Anthropicの並列Claude実験でも、OpenAIのCodex開発でも、最終的に重要になっていたのはモデルそのものだけではなく、
Harness
でした。
Jevは、このHarnessの中に、
高速な「曖昧判断レイヤー」
を追加する技術と考えると分かりやすいでしょう。
そして今後のAI駆動開発では、
「どのAIを使っていますか?」
以上に、
「AIが間違ったとき、どう検知して、どこで止めますか?」
という質問のほうが重要になっていくのではないでしょうか。